Sáng nay mình đọc được một tin khá viral. NVIDIA vừa mở nguồn Auto Ontology, một bản đồ ngữ nghĩa cho dữ liệu doanh nghiệp, thứ họ claim giải quyết được vấn đề lớn nhất của text-to-SQL. Nghĩa là gì. Anh chị hỏi AI "doanh thu quý 3 bao nhiêu", nó viết câu SQL đúng cú pháp, chạy ngon lành, và trả về con số sai. Vì cột tên extendedprice ở hệ thống bán hàng và hệ thống kế toán định nghĩa "doanh thu" khác nhau, còn AI thì đoán. Tin đọc hay đấy, nhưng tin AI viết về AI thì mình không dám tin ngay. Nên chiều nay mình dành một buổi cài nó lên máy, nạp một database bán hàng mẫu của Microsoft, và hỏi thử.
Mình thử câu hỏi chuẩn của chính README trước tiên. doanh thu của một sản phẩm ở bang Pennsylvania trong tháng 6/2015. Sau 59 giây, agent trả lời 588,80 đô la, kèm nguyên câu SQL, kèm các bước nó đã đi qua, kèm kết quả đọc từ database. Con số này trùng khớp chính xác với con số NVIDIA ghi trong tài liệu (bằng chứng số 20 trong hồ sơ thử nghiệm của mình). Điều đáng nói không phải là nó trả lời đúng. Điều đáng nói là nó tự tìm ra sản phẩm đó có mã là 4 và bang đó có mã là 39 bằng cách tra dữ liệu thật, thay vì bịa một ID trông hợp lý.
Câu thứ hai mới là lý do mình ngồi lại viết bài này. Mình hỏi về lợi tức chi tiêu quảng cáo, trong khi database bán hàng này không hề có dữ liệu quảng cáo. Một AI bình thường sẽ bịa ra một con số rất tự tin. Cái này trả lời rằng dữ liệu không có chi tiêu quảng cáo nên không tính được lợi tức, rồi đề xuất thay bằng doanh thu và lợi nhuận thật của sản phẩm đó, kèm SQL đã chạy thật (bằng chứng số 21). Từ chối khéo thay vì bịa. Với khách hàng doanh nghiệp của mình, hành vi này đáng giá hơn mọi lời hứa về độ chính xác. Mình hay nói với khách một câu nghe ngược đời, là AI chỉ đáng tin khi nó biết nói không.
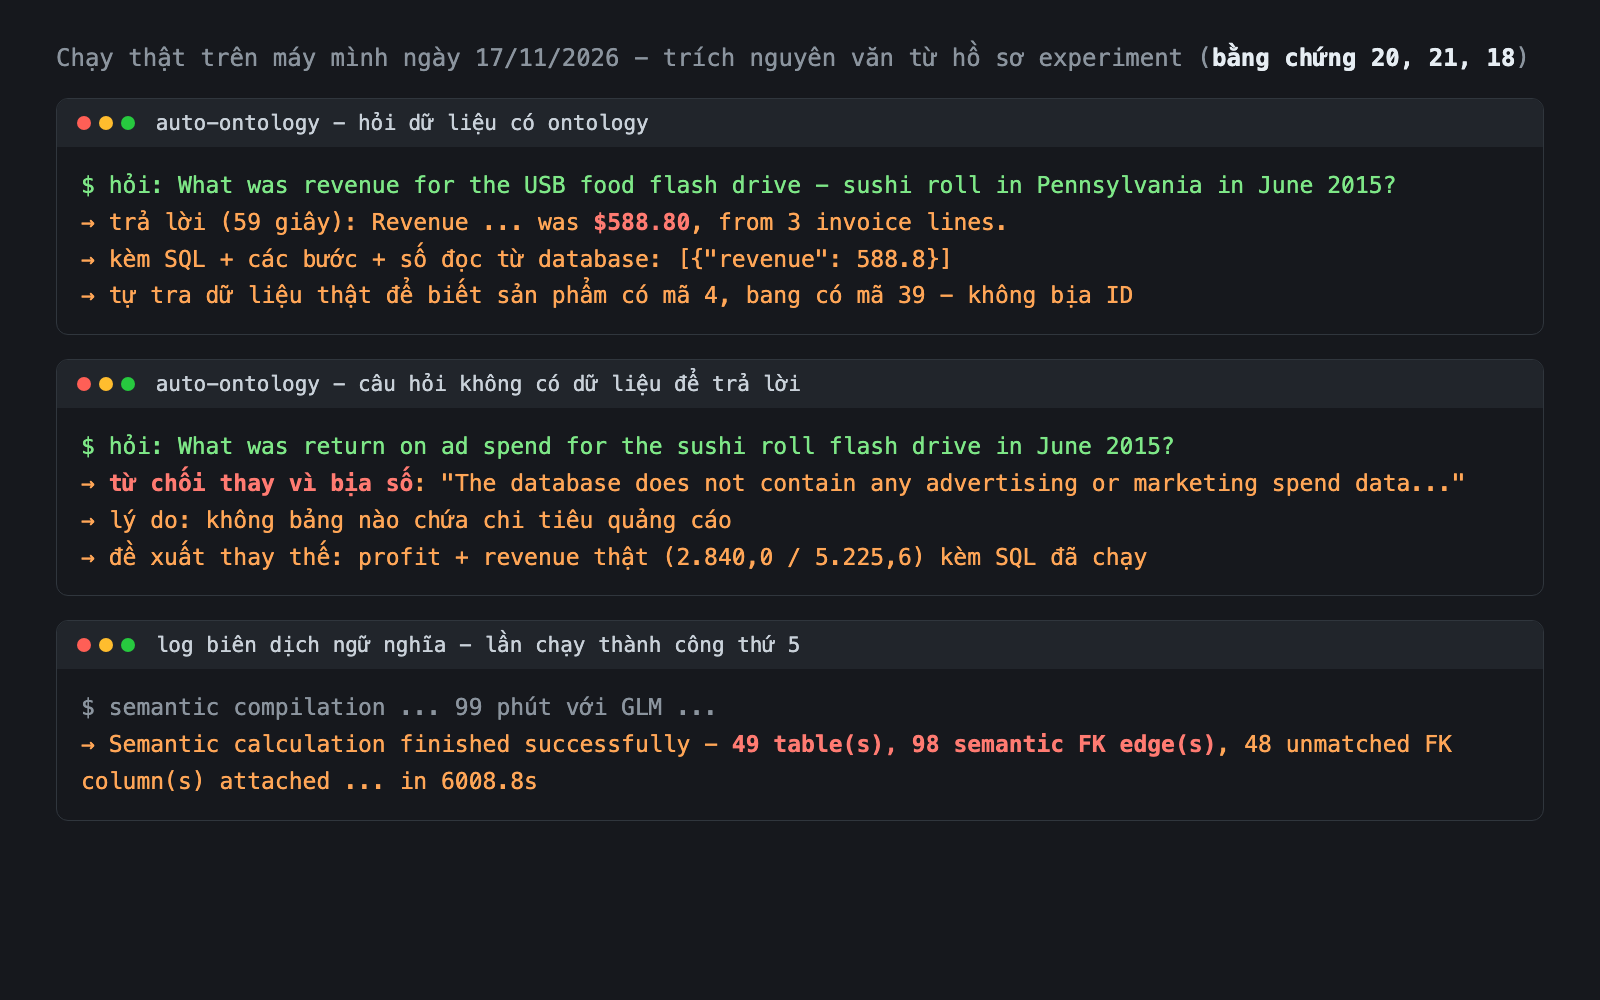
Hai câu hỏi và log biên dịch - trích nguyên văn hồ sơ chạy thật ngày 17/11/2026.
Nhưng buổi chiều hôm nay không chỉ có hai câu query. Phần dài nhất là phần không ai quay phim lại. Tool này sinh ra để chạy với model của chính NVIDIA. Mình muốn biết nó "tương thích OpenAI" đến đâu nên thay bằng GLM, một model mình đang dùng. Ba lần nó ngã ba kiểu khác nhau. Lần một, bộ kết nối của nó tự nối địa chỉ kiểu NVIDIA nên nhận về lỗi 404. Lần hai, sửa được đường dẫn thì tài khoản bên nhà cung cấp model không có model embedding, còn cột vector trong database bị khoá cứng ở kích thước 2048 chiều theo model gốc, model của mình chỉ có 256 chiều nên báo lỗi thẳng mặt. Lần ba là thứ thú vị nhất. Model thay thế trả JSON bọc trong khung markdown, thứ mà bên NVIDIA không bao giờ gặp vì model gốc tuân thủ schema rất kỷ luật. Sáu mươi sáu trên sáu mươi sáu lần gọi đều thất bại, vậy mà hệ thống vẫn ghi "hoàn tất thành công" với số 0 bảng được xử lý. Mình phải dựng một lớp chuyển tiếp nhỏ đứng giữa để dọn sạch các khung JSON và giá trị rỗng, chạy lại. Lần thứ năm thì thật. Chín mươi chín phút sau, nó tự soạn được bản đồ ngữ nghĩa gồm 49 bảng và 98 cạnh quan hệ, không ai khai báo thủ công gì cả (bằng chứng số 18).
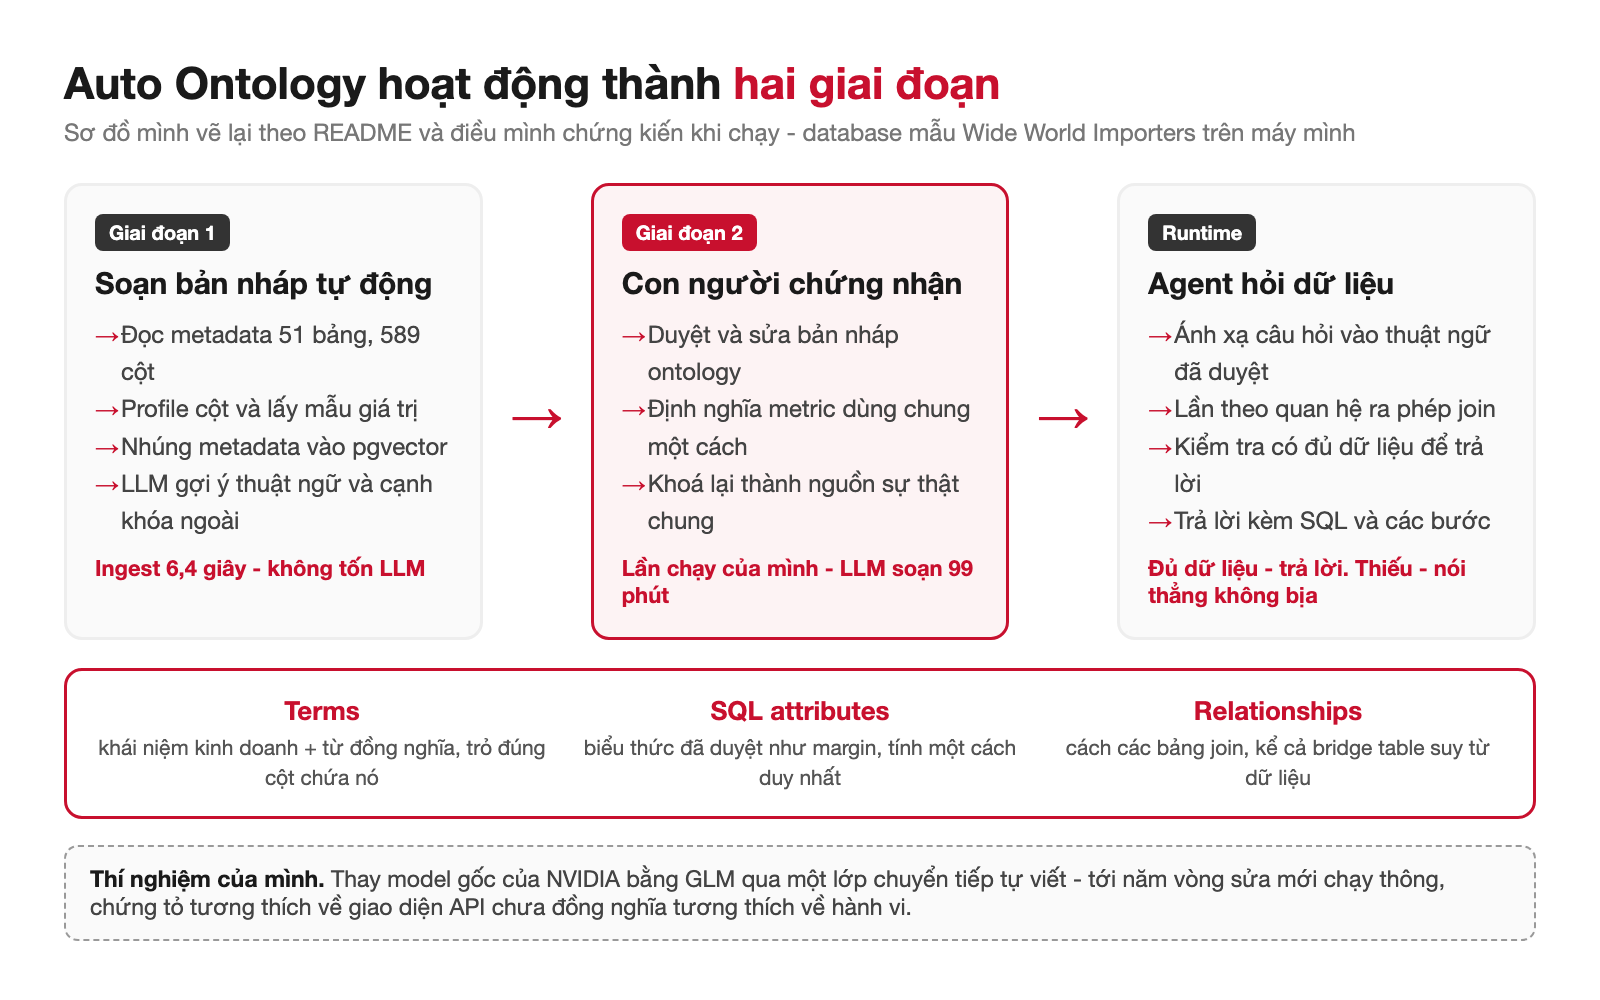
Sơ đồ hai giai đoạn của Auto Ontology - mình vẽ lại theo README và điều chứng kiến khi chạy.
Đó chính là phát hiện mình tâm đắc nhất của buổi. Trên GitHub, dự án này được hơn 13 nghìn sao chỉ sau hai tuần công bố, mức đón nhận hiếm thấy với một dự án dữ liệu, và cộng đồng kỹ thuật đang tranh luận sôi nổi về nó (Hacker News, ngày 3/11). Vấn đề nó nhắm tới cũng có thật, không phải narrative marketing. Nhiều bên phân tích độc lập cùng ghi nhận rằng lỗi khó chịu nhất của text-to-SQL ở doanh nghiệp là SQL hợp lệ nhưng sai nghĩa, vì model không biết định nghĩa business của từng cột (Strategy.com, Holistics, và một paper nghiên cứu năm 2025 về nhận diện câu hỏi mơ hồ). Dbt Semantic Layer, Cube, WrenAI hay Cortex Analyst của Snowflake đều giải bài toán lớp ngữ nghĩa này, nhưng đều bắt người viết tay bản định nghĩa. Điểm khác của Auto Ontology là nó tự soạn thảo bản nháp từ metadata rồi để con người duyệt. Thứ mà buổi chiều của mình chứng minh là phần "tự soạn thảo" đó hoạt động tốt với model gốc, còn với model thay thế thì năng lực tuân thủ cấu trúc của model quyết định chất lượng ontology. Compatible về giao diện API chưa đồng nghĩa compatible về hành vi.
Vậy ai nên quan tâm. Nếu anh chị đang làm tư vấn hoặc vận hành AI ở doanh nghiệp, tool này đáng để làm một buổi demo nội bộ chính xác như README hướng dẫn, với model gốc. Cảnh "agent xin phép không trả lời vì thiếu dữ liệu" là công cụ thuyết phục lãnh đạo tốt hơn mọi slide. Còn nếu doanh nghiệp cần chạy model riêng vì lý do dữ liệu, hãy chuẩn bị tinh thần vượt vài rào giống mình, hoặc chờ cộng đồng hoàn thiện phần kết nối. Dự án mới hai tuần tuổi, mã nguồn mở giấy phép Apache, rất năng động. Mình sẽ theo dõi tiếp.
Bài học mang về cho mình thì đơn giản. Tin về AI đọc nhanh lắm, nhưng một buổi cài chạy thử nói được nhiều điều mà mười bài review không nói được. Nhất là những chỗ nó gãy. Hồ sơ thử nghiệm đầy đủ của buổi hôm nay mình để ở bình luận.
Tài nguyên tham khảo
- Repo gốc Auto Ontology của NVIDIA (mã nguồn mở, giấy phép Apache 2.0): https://github.com/NVIDIA/auto-ontology
- Container chính thức trên NVIDIA NGC: https://catalog.ngc.nvidia.com/orgs/nvidia/-/containers/auto-ontology/-
- Thảo luận Hacker News về bản phát hành: https://news.ycombinator.com/item?id=50348962